막시밀리안 카시(Maximilian Kasy)의 논문 「The political economy of AI: Towards democratic control of the means of prediction」(INET Oxford Working Paper No. 2023-06)을 한국어로 번역했다. 저자 막시밀리안 카시의 허락을 받아 공개하는 비공식 번역이며, 원문은 PDF로 읽을 수 있다. 이 글은 The Oxford Handbook of Algorithmic Governance and the Law(Oxford University Press, 2026)에도 실렸다. 각주는 원문처럼 해당 절 안에 두었고, 참고문헌은 원문 그대로 두었다.
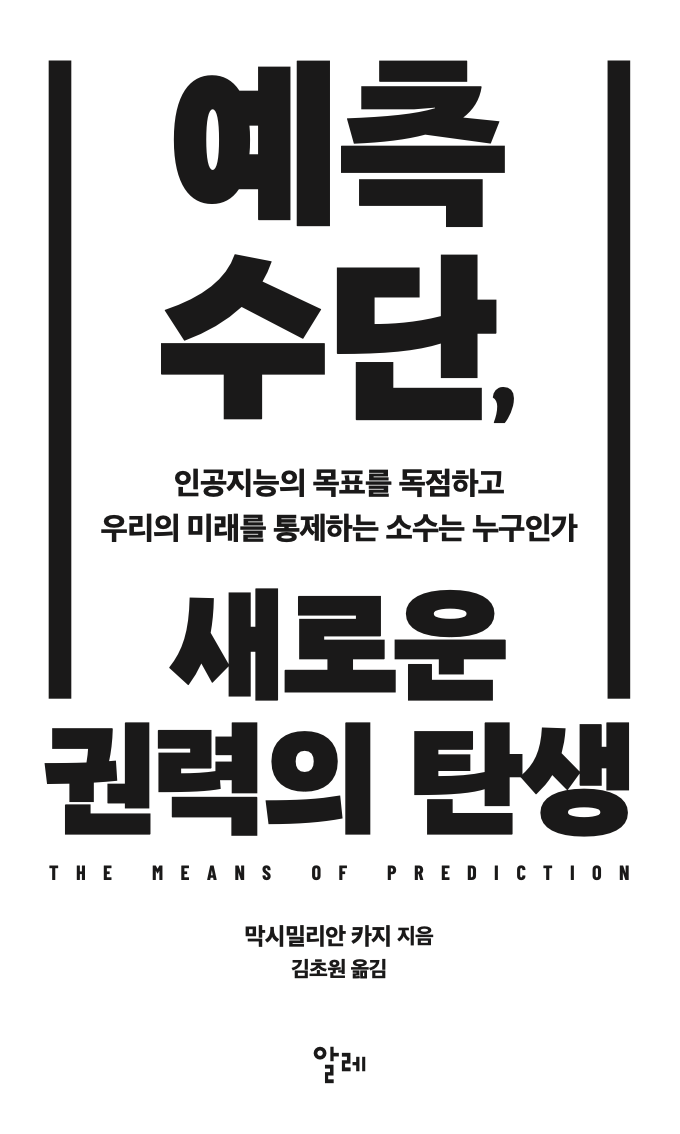
같은 저자의 책 『The Means of Prediction: How AI Really Works (and Who Benefits)』(University of Chicago Press, 2025)가 이 글의 논의를 더 넓게 다룬다. 한국어판 『예측 수단, 새로운 권력의 탄생』(김초원 옮김)은 학산문화사의 인문·교양 브랜드 알레(ALLEZ)에서 곧 출간될 예정이다. 알레는 삶의 방향과 성장을 다루는 책을 펴내는 학산문화사의 새로운 브랜드다. (이번 일을 계기로 처음 알았다...!) 아래 표지 시안은 카시 교수에게 직접 받은 것이다.
다른 번역글은 번역 카테고리에서 볼 수 있다.
막시밀리안 카시(Maximilian Kasy)*, 2023년 4월 14일
* 이 장은 여러 사람의 피드백과 토론에서 많은 도움을 받았다. Rediet Abebe, Daron Acemoglu, David Autor, Carlos Gonzalez Perez, Lukas Lehner, Sanaz Mobasseri, 그리고 옥스퍼드 머신러닝·경제학 독회(Oxford Machine Learning and Economics reading group)와 MD4SG 불평등 그룹(MD4SG inequality group)의 참가자들께 감사드린다.
1 서론
이 장은 정치경제학(political economy)의 관점에서 인공지능(artificial intelligence, AI)의 규제를 다룬다. 여기서 말하는 "정치경제학"이란 사회에는 서로 다른 이해관계를 지닌 다양한 사람과 행위자가 있으며, 이들이 자원과 권력에 접근할 수 있는 정도가 불평등하다는 점을 강조하는 관점이다. 또 "인공지능"이란 어떤 형태의 보상(reward)을 최대화하는 자율 시스템을 구축하는 일을 가리킨다. 이런 시스템을 만들 때는 대개 머신러닝(machine learning)과 최적화(optimization)의 도구를 활용한다.
AI와 머신러닝은 사회적으로 중대한 결과를 낳는 영역에서 점점 더 폭넓게 쓰이고 있다. 노동시장, 교육, 형사사법, 보건, 금융, 주거는 물론, 검색엔진과 소셜 네트워크, 추천 시스템(recommender system)이 정보를 선별하고 배열하는 일도 여기에 포함된다. 기술 혁신이 어떤 방향으로 나아가야 하는지, 기술을 어떻게 사용해야 하는지, 기술에 어떤 제약을 두어야 하는지에 관해 공적 논의가 필요하다. 이 장에서는 그러한 논의의 틀을 잡는 데 도움이 될 몇 가지 분석틀을 검토한다.
이 장의 논의는 분명한 입장을 취하며, 다음과 같은 전제에서 출발한다.
- AI는 측정 가능한 목표(보상)를 최대화하는 시스템을 구축하는 일이다. 이런 시스템은 데이터를 입력으로 받아 선택된 행동을 출력으로 내놓는다.
- 자율 시스템이 단일한 목표를 최대화하는 일은, 개인마다 서로 다른 목표를 지닌 사회적 세계 안에서 일어난다. 이렇게 서로 다른 목표들은 충돌할 수도 있다. 이 다양한 목표를 기준으로 평가하면, AI 시스템이 선택하는 행동과 정책은 (거의) 언제나 승자와 패자를 낳는다.
- 개인 수준의 이득과 손실에 대한 평가에서 사회 수준의 평가로 넘어가려면 집계(aggregation)가 필요하며, 집계는 개인들 사이에서 이득과 손실을 서로 저울질하는 일이다. AI와 그에 대해 제안된 규제를 규범적으로 평가하려면, 그로 인해 생기는 개인별 이득과 손실을 명시적으로 평가하고, 이를 개인들에 걸쳐 명시적으로 집계해야 한다.
- 공정성, 프라이버시, 가치 정렬(value alignment), 책임성(accountability), 자동화 등 AI가 제기하는 사회적 문제는 알고리즘의 목표, 그리고 그 목표를 달성하는 수단인 데이터와 컴퓨팅 인프라를 민주적으로 통제해야만 해결할 수 있다. 민주적 통제에는 사회의 여러 층위에서 이루어지는 공적 토론과 구속력 있는 집단적 의사결정이 필요하다.
이 장의 논의는 머신러닝, 경제학, 사회선택이론(social choice theory)의 개념과 문헌에 기대고 있다. 인공지능의 윤리와 사회적 영향을 둘러싼 여러 논쟁을 다루지만, 이 주제에 관해 방대하고 빠르게 늘어나는 문헌을 충실히 정리하려는 것은 아니다. 대신 내적으로 일관되고 원칙에 입각한 설명을 제시하는 것이 목표다.
구성과 개요
이 장의 나머지 부분은 두 부분으로 나뉜다. 2절에서는 AI의 정치경제학을 이해하는 데 필요한 배경 지식을 검토한다. 여기서는 기술이 어떻게 작동하는지(2.1절), 이런 기술의 도입으로 누가 이득을 보고 누가 손해를 보며 그에 따른 이득과 손실을 어떻게 평가해야 하는지(2.2절), 그리고 누가 AI의 목표를 결정하고 예측 수단(means of prediction)을 통제하는지(2.3절)를 논의한다. 이어 3절에서는 이 배경 지식을 바탕으로, AI의 윤리와 사회적 영향, 규제에 관한 논쟁에서 주목받아 온 여러 쟁점을 하나의 틀 안에서 논의한다.
2.1절에서는 AI와 머신러닝의 몇몇 하위 분야를 간략히 개관한다. 여기에는 지도학습(supervised learning)과 심층 신경망(deep neural nets), 표적화된 처치 배정(targeted treatment assignment), 다중 슬롯머신 문제(multiarmed bandits), 강화학습(reinforcement learning)이 포함된다. 특히 각 하위 분야에서 개발된 알고리즘이 최대화하는 목적함수(objective function)에 주목한다. 이어 2.2절에서는 개인 후생(welfare)의 평가와 사회후생함수(social welfare function)를 통한 그 집계에 기초한 규범적 분석틀을 논의한다. 사회선택이론과 후생경제학(welfare economics), 그리고 정치철학의 상당 부분을 떠받치는 이 규범적 분석틀은 사람들 사이에 서로 다른 목표가 여럿 존재한다는 사실을 분명히 드러낸다. 나는 AI의 사회적 영향을 여러 사람의 후생에 미치는 영향이라는 관점에서 평가할 때 이 분석틀을 사용해야 한다고 주장한다. 2.3절에서는 사회 변화의 주체와 민주적 통제에 관한 논쟁을 간략히 살펴본다. 이는 사회후생 분석이라는 규범적 관점을 보완한다. 여기서 나는 AI의 목표를 사회 전체의 목표와 정렬하려면 사회의 여러 층위에서 민주적 통제가 필요하다고 주장한다.
3절에서는 AI의 윤리와 사회적 영향, 규제를 둘러싼 여러 논쟁을 다룬다. 공정성, 차별, 불평등(3.1절), 프라이버시, 데이터 재산권, 데이터 거버넌스(3.2절), 가치 정렬과 임박한 로봇 종말론(3.3절), 자동화된 의사결정의 설명가능성(explainability)과 책임성(3.4절), 그리고 자동화와 AI가 노동시장 및 임금 불평등에 미치는 영향(3.5절)이 그것이다. 3절의 각 하위 절은 서로 독립적으로 읽어도 무방하다.
2 배경
2.1 AI와 머신러닝
AI 전반, 그리고 특히 머신러닝은 규모가 크고 빠르게 성장하는 분야로, 새로운 접근법이 끊임없이 주목받고 있다. 그러나 최적화와 통계학에 기반을 둔 근본 원리 상당수는 시간이 흘러도 놀라울 만큼 변하지 않았다. AI를 효과적으로 규제하려면 이 원리를 이해하는 것이 필수적이다. 아래에서는 머신러닝의 몇 가지 원리와 접근법을 큰 틀에서 간략히 개관한다.¹ 이 절 전체에 걸쳐, 번호를 붙인 수식은 AI의 여러 분야와 경제학에서 고려하는 서로 다른 목적함수를 보여 준다.
¹ 이 절의 개관은 머신러닝의 기초에 관한 나의 강의 슬라이드를 바탕으로 한 것이다. 슬라이드는 https://maxkasy.github.io/home/ML_Oxford_2022/ 에서 볼 수 있다.
자동화된 의사결정으로서의 AI
AI 분야의 대표적인 교과서 중 하나(Russell and Norvig 2016, chapter 2)는 AI를 합리적 에이전트(rational agent)를 구축하는 일로 정의한다. 에이전트는 지각 장치(perceptor), 즉 센서를 통해 환경으로부터 정보를 받고, 작동 장치(actuator)를 통해 환경에 작용한다. 에이전트 프로그램은 지각의 연쇄를 행동으로 대응시킨다. 이때 합리적 에이전트는 다음과 같이 정의된다.
가능한 각각의 지각 연쇄에 대해, 합리적 에이전트는 그 지각 연쇄가 제공하는 증거와 에이전트가 내장하고 있는 지식을 바탕으로, 자신의 성과 척도(performance measure)를 최대화할 것으로 기대되는 행동을 선택해야 한다.
이 일반적 정의는 합리적 에이전트를 구축하는 매우 다양한 접근법을 포괄한다. 지금의 논의에서 핵심적으로 중요한 것은 성과 척도, 곧 "보상"이다. 다시 말해 AI가 최대화하려는 것이 무엇인가 하는 문제다. 나는 민주적 토론과 의사결정이 바로 이런 성과 척도의 선택에 초점을 맞추어야 한다고 주장할 것이다.
오늘날 AI의 주된 접근법은 머신러닝에 기반을 두고 있으며, 이후 논의도 머신러닝에 초점을 맞춘다. 이는 과거에 주류였던 다른 접근법과 다르다. 그런 대안적 접근법의 하나가 "전문가 시스템(expert system)"의 구축이다. 전문가 시스템은 인간 전문가가 직접 코딩한 지식 데이터베이스를 바탕으로 자동화된 논리적 추론을 수행한다. 반면 머신러닝은 통계적 추론을 활용하고, (대규모) 데이터셋에 기대며, 지식의 축적을 가능한 한 자동화한다.
지도학습
지도학습은 새로운 데이터 포인트에 대해, 관찰 가능한 특성(feature) X가 주어졌을 때 결과 Y를 예측하는 문제를 다룬다(Shalev-Shwartz and Ben-David, 2014). 이 패러다임은 회귀(regression), 분류(classification), 그리고 더 일반적으로는 예측을 포괄하며, 응용 범위가 매우 넓다. 이미지 인식(이미지 X가 주어졌을 때 레이블 Y를 예측), 음성 인식(소리 X가 주어졌을 때 텍스트 Y를 예측), 자동 번역(한 언어로 된 텍스트 X가 주어졌을 때 다른 언어로 된 텍스트 Y를 예측), 게임에서의 형세 평가(국면 X가 주어졌을 때 승리 확률 Y를 예측) 등이 그 예다.
사회적으로 직접 중대한 결과를 낳는 영역에서의 지도학습 응용으로는 구직자 평가(직원의 특성 X가 주어졌을 때 성과 지표 Y를 예측), 법원에서 피고인의 보석 결정(피고인의 이력 X가 주어졌을 때 향후 범죄 Y를 예측), 대출 신청자 평가(신청자의 특성 X가 주어졌을 때 상환 확률 Y를 예측), 대학 지원자 평가(지원자의 이력 X가 주어졌을 때 향후 시험 성적 Y를 예측) 등이 있다. 지도학습은 검색엔진과 소셜미디어(특정 광고나 게시물, 그리고 특성 X를 지닌 사용자에 대해 클릭 Y를 예측), 추천 시스템(특정 영화와 시청 이력 X를 지닌 사용자에 대해 평점 Y를 예측)에서도 쓰인다.
지도학습 방법은 표본 외(out-of-sample) 예측 오차의 평균을 기준으로 평가된다. 여기서 몇 가지 표기를 도입해 두면 편리하다. g(X)를 특성 X에 의존하는 예측값이라고 하자. 여기서 함수 g는 이용 가능한 관측치 (Xi, Yi)를 바탕으로 학습해야 한다. 지도학습의 성과 척도는 평균 예측 손실로 주어진다.
E[l(g(X), Y)], (1)
여기서 l은 예측 오차를 평가하는 데 쓰이는 손실함수(loss function)이고, E[ · ]는 (X, Y)의 새로운 추출("표본 외")에 대한 평균(기댓값)을 나타낸다. 분류 문제에서 흔히 쓰이는 손실함수는 분류 오류 손실로, 예측이 맞은 경우, 즉 g(X) = Y인 경우에만 l = 0이고 그 밖의 경우에는 l = 1이다. 연속적인 결과를 예측할 때는 제곱 오차 (g(X) − Y)2가 흔히 쓰인다. 지도학습의 목표는 이용 가능한 관측치를 바탕으로 평균 예측 손실을 최소화하도록 g를 선택하는 방법을 찾는 것이며, 이를 "훈련(training)" 또는 "추정(estimation)"이라고 부른다.
예측 방법을 선택할 때는 대개 근사 오차("편향(bias)")와 추정 오차("분산(variance)") 사이의 상충관계(tradeoff)가 생긴다. 이미 확보한 과거 관측치 i 모두에 대해("표본 내(in sample)") 손실 l(g(Xi), Yi)를 작게 만드는 방법이라도, 새로운 데이터 포인트에 대해서는("표본 외") 평균 예측 손실이 클 수 있다. 이런 현상을 과적합(overfitting)이라고 한다. 지도학습 방법은 과적합을 억제해야 한다. 편향과 분산 사이에서 이런 균형을 잡는 흔한 방법은 데이터 분할(data splitting)이다. 데이터의 한 부분으로 알고리즘을 실행하고, 다른 부분으로 그 평균 예측 손실을 추정한다. 그런 다음 추정된 평균 예측 손실이 최소가 되도록 알고리즘을 미세 조정한다.
관측치 i가 많아지고 예측에 쓰이는 특성 X가 풍부해질수록, 그리고 이를 더 유연한 모형 g와 결합할수록 예측 오차는 작아진다. 21세기 머신러닝의 진보 가운데 상당 부분은 이런 측면에서의 개선과, 그에 상응하는 컴퓨터 하드웨어의 발전에서 비롯되었다.
딥러닝
지도학습의 특정한 접근법 하나가 이른바 딥러닝(deep learning)으로(Goodfellow et al., 2016), 인공 신경망(artificial neural network)을 사용한다. 최근 몇 년 사이 가장 눈부신 성공을 거둔 접근법이 바로 이것이다. 간단히 말해 딥러닝은 입력 특성 X를 예측값으로 대응시키는 특정한 함수족 g(X)를 사용하는 것이다. 딥러닝에서 이 함수들은 매우 많은 수의 더 원초적인 함수들을 조합해 만들어지는데, 이 원초적인 함수들은 인자를 받아 출력, 곧 "활성화(activation)"로 대응시키는 뉴런으로 해석된다. 이런 신경망을 "훈련"한다는 것은 평균 예측 손실이 작은 함수 g를 찾는다는 뜻이다. 신경망은 대개 복잡한 비선형 함수 g를 표현하기 때문에, 그 훈련(최적의 g를 찾는 일)에는 어려운 최적화 문제가 따른다. 특정 예측 문제에서 성능이 좋은 "아키텍처(architecture)"(g의 함수 형태)를 미세 조정하는 일과 더불어, 이런 최적화 문제를 풀기 위한 하드웨어와 알고리즘 개발에도 많은 노력이 투입되었다.
딥러닝은 특성 X의 풍부함과 관측치 i의 수라는 두 측면 모두에서 데이터셋이 매우 큰 환경에서 특히 성공적이다. 훈련된 신경망은 훈련에 쓰인 사례 (Xi, Yi)를 부호화한 데이터베이스라고 생각할 수 있다. 이런 신경망은 과거 사례들 사이를 보간(interpolate)하여 새로운 관측치에 대한 예측을 만들어 낸다. 다만 데이터셋이 더 작고 특성이 덜 풍부한 경우에는 딥러닝이 더 전통적이고 단순한 예측 모형보다 성과가 떨어지는 경우가 많다는 점에 유의해야 한다. 사회과학에서, 그리고 노동시장이나 교육 분야의 응용에서 흔히 볼 수 있는 데이터셋이 그런 예다.
표적화된 처치 배정
예측은 응용 범위가 넓은 풍부한 패러다임이지만, 자동화된 의사결정의 맥락에서는 대개 중간 단계에 불과하다. 구직자 평가, 법원에서 피고인의 보석 결정, 대출 신청자 평가, 대학 지원자 평가, 검색 피드의 선별 같은 환경에서 목표는 대개 관찰된 특성 X를 바탕으로 결정 W를 내리는 것이다(Kitagawa and Tetenov, 2018; Athey and Wager, 2021). 채용, 구금, 대출 승인, 입학 허가, 특정 게시물 노출 등이 그런 결정이다.
달리 말하면, 문제는 어떤 목표를 최대화하는 처치 배정 정책(treatment assignment policy) W = h(X)를 찾는 것이다. 이항 처치 W ∈ {0, 1}의 경우 전형적인 목표는 다음과 같다.
E[h(X) · (Y − c)]. (2)
이 목표에 대한 이상적인 처치 배정은 결과 Y가 임계값 c를 넘는 모든 사람을 처치하는 것이다. 성과가 임계값을 넘는 사람은 모두 채용하고, 상환 확률이 임계값을 넘는 사람에게는 모두 대출을 해 주는 식이다. 하지만 새로운 지원자의 Y는 알 수 없으므로 이런 이상적인 처치 배정은 실행할 수 없다. 그 대신 자동화된 처치 배정은 지도학습 방법 g(X)를 사용해 관찰 가능한 특성 X로부터 Y를 예측할 수 있다. 이런 예측을 바탕으로 하면, 예측된 결과가 임계값을 넘는 모든 사람을 처치하는 것, 즉 g(X) ≥ c인 경우에만 h(X) = 1로 두는 것이 최적이다.
주의 깊은 독자라면 식 (2)의 목표가 사실은 식 (1)의 목표의 특수한 경우임을 눈치챘을 것이다. l(h(X), Y) = −h(X) · (Y − c)로 두면 된다. 그러나 문제를 복잡하게 만드는 것은, 데이터에서 Yi가 Wi = 1인 경우에만 관찰될 수 있다는 점이다. 예를 들어 은행은 실제로 대출을 받은 사람의 상환 확률만 알 뿐, 대출을 거절당한 사람의 상환 확률은 알지 못한다. 이런 부분적 관찰 가능성은 선택 편향(selection bias)을 낳을 수 있으며, 이 주제는 계량경제학과 관련 분야의 인과추론(causal inference) 문헌에서 많은 관심을 받아 왔다(Imbens and Rubin, 2015).
다중 슬롯머신 문제
지금까지 논의한 방법들은 때로 "오프라인(offline)" 방법이라고 불린다. 이는 학습이 주어진 고정된 데이터셋 (Xi, Yi)에 대해 이루어진다는 뜻이다. 이런 데이터셋으로부터 학습한 뒤에는 고정된 예측 규칙 g(X)나 처치 배정 규칙 h(X)가 실행된다.
이와 대비되는 것이 "온라인(online)" 환경이다. 온라인 환경에서는 시간의 흐름에 따라 결정을 내려야 하고, 새로운 데이터가 들어올 때마다 결정 규칙이 갱신된다. 온라인 의사결정 문제의 대표적인 예가 "다중 슬롯머신(multiarmed bandit)" 환경이다(Bubeck and Cesa-Bianchi, 2012). 이 환경에서는 단위 i가 시간에 걸쳐 차례로 도착하고, 알고리즘은 각 단위에 대한 처치 Wi를 결정해야 한다. 그러면 결과 Yi가 실현되어 관찰되는데, Yi는 Wi의 영향을 받을 수 있다. 알고리즘은 과거의 처치와 결과의 이력을 바탕으로 다음 단위를 어떻게 처치할지 결정하고, 이 과정이 계속 이어진다. 주어진 시간 범위 T에 대해, 목표는 결과 Yi의 시간 평균을 최대화하는 것이다.
1/T Σi = 1TYi. (3)
다중 슬롯머신 기법이 쓰일 만한 전형적인 환경으로는 온라인 광고(클릭 Y를 가장 많이 만들어 내는 콘텐츠나 레이아웃 W를 노출), 온라인 가격 책정(이윤 Y를 가장 크게 만드는 가격 W를 설정), 임상시험(환자의 생존 가능성 Y를 최대화하는 처치 W를 배정) 등이 있다.
다중 슬롯머신 환경에서 특정 단위에 대한 처치 선택은 두 가지 목적을 지닌다. 첫째는 지금 좋은 결과를 얻는 것이고, 둘째는 대안적인 처치들의 효과를 학습하여 앞으로 더 나은 결과를 얻는 것이다. 즉 "활용(exploitation)", 곧 지금 좋은 처치를 고르는 것과 "탐색(exploration)", 곧 미래의 처치 선택을 위해 학습하는 것 사이에 상충관계가 있다. 좋은 알고리즘은 이 두 목표 사이에서 (근사적으로) 최적의 균형을 찾아내며, 그럼으로써 최적의 처치를 빠르게 학습하고 좋은 평균 결과 Y를 달성한다.
기본적인 다중 슬롯머신 환경을 일반화한 것이 맥락적 슬롯머신(contextual bandit) 환경으로, 슬롯머신 환경과 표적화된 처치 배정 문제를 결합한 것이다. 맥락적 슬롯머신은 이번에도 탐색과 활용 사이의 균형을 잡으면서 최적의 표적화 규칙 h(X)(예컨대 어떤 인터넷 사용자에게 어떤 광고를 보여 줄지, 또는 어떤 유형의 환자에게 어떤 처치를 배정할지)를 학습한다. 이때 특성 X를 이런 처치 배정 결정의 "맥락(context)"이라고 부른다.
강화학습
맥락적 슬롯머신에서는 새로운 관측치의 특성 X가 과거의 처치 배정 결정에 의존하지 않는다. 그러나 많은 환경에서는 과거의 행동이 현재의 상태에 영향을 미친다. 이런 상황은 마르코프 결정 문제(Markov Decision Problem)의 틀로 포착된다(Sutton and Barto, 2018). 이 틀에서는 직전 기간의 행동이 현재 상태에 영향을 미칠 수 있다(다만 미래에 간접적인 효과를 미치지는 않는다). 마르코프 결정 문제는 완전한 관찰 가능성 아래에서 환경과의 목표 지향적 상호작용을 다루는 일반적인 모형을 제공한다. 마르코프 결정 문제의 목표 역시 식 (3)에서처럼 보상의 흐름을 최대화하는 것이다. 마르코프 결정 문제의 한 예로 체스나 바둑 같은 게임을 들 수 있다. 이런 게임에서는 대부분의 상태에서 대부분의 행동이 직접적인 보상을 낳지 않는다. 대신 판의 국면 X를 바꾸고, 이것이 미래 보상 Y, 곧 게임에서 이길 확률에 영향을 줄 수 있다. 상태 X에서 행동 W를 취했을 때의 기대 미래 보상(또는 "가치 함수(value function)")을 Q(X, W)로 나타내자. 상태 Xi에서의 최적 행동 Wi는 Q(Xi, W)를 최대화하는 W 값이다. 가치 함수는 다음과 같이 분해할 수 있다.
Q(Xi, Wi) = E[Yi + Q(Xi + 1, Wi + 1) | Xi, Wi], (4)
여기서 우변은 조건부 기대값, 즉 현재 상태 Xi와 현재 행동 Wi가 주어진 값을 갖는 모든 사례에 대한 평균이다. 이 분해를 벨만 방정식(Bellman equation)이라고 한다. 알고리즘은 Wi를 고를 때 현재 보상 Yi에 미치는 효과와 미래 보상 Q(Xi + 1, Wi + 1)에 미치는 효과를 함께 고려해야 한다. 미래 보상에 대한 효과는 Wi가 Xi + 1에 미치는 효과를 거쳐 나타난다.
강화학습(reinforcement learning)은 행동이 보상과 미래 상태에 미치는 효과를 모두 알지 못해 학습으로 알아내야 하는 마르코프 결정 문제를 다룬다. 대표적인 접근법은 주어진 상태 X와 행동 W에 대한 기대 미래 보상 Y, 즉 가치 함수 Q(X, W)를 직접 학습하는 것이다. 예를 들어 체스나 바둑 같은 게임에서 이 접근법은 판의 상태 X와 다음 수 W가 주어졌을 때 이길 확률을 직접 예측한다. 가치 함수를 추정하는 일은 Xi, Wi가 주어졌을 때 Yi + Q(Xi + 1, Wi + 1)를 예측하는, 재귀적 형태의 지도학습(supervised learning) 문제라고 할 수 있다. 가치 함수는 예컨대 바둑판의 특정 배치에서 이길 확률을 나타낸다. 가치 함수 추정에는 딥러닝(deep learning)을 활용할 수 있다. 이러한 "심층 강화학습(deep reinforcement learning)" 접근법이 성공적으로 적용되면서 체스와 바둑에서 인간 고수를 이기는 획기적인 성과가 나왔다.
2.2 사회후생
AI(자동화된 의사결정으로 정의한)와 머신러닝(AI의 주된 접근법)을 간략히 살펴보았으니, 이제 자동화된 의사결정 시스템을 규범적으로 평가하기 위한 틀로 넘어간다. 이 절은 Sen (1995)과 Roemer (1998)가 제시한 사회선택이론(social choice theory)과 정의론(theories of justice)의 설명에 느슨하게 기대고 있다.² 나는 사회후생(social welfare)을 평가하는 일반적인 틀, 즉 어떤 사회가 얼마나 "좋은지"를 수량화하는 틀과 이 틀에서 제기되는 핵심 질문 몇 가지를 논의할 것이다. 이 틀은 고려 대상인 모든 개인의 후생을 먼저 평가한 다음 이를 집계해 사회후생을 평가한다는 점에서 개인주의적이다. 이러한 틀은 사회정의에 관한 매우 다양한 견해와 양립한다. 몇 가지 예외는 아래에서 언급할 것이다.
AI 기반 기술의 도입과 AI를 규제하는 정책은 사회후생에 영향을 미친다. 어떤 기술이나 정책이 사회후생을 높인다면 그것은 바람직하다고 여겨진다. 내가 여기서 이 틀을 소개하는 것은 AI의 사회적 영향과 규제를 체계적으로 평가하는 방법을 제시하기 위해서다. 이 틀은 사회에는 개인들 사이에 서로 충돌하는 여러 목표가 존재한다는 점을 강조한다. 이는 단일 행위자의 단일한 목표를 최적화하는 데 초점을 맞추는 머신러닝과 대조된다.
² 이 절은 나의 공개 온라인 교재 Kasy (2016)의 2장에도 기대고 있다. 이 교재는 http://inequalityresearch.net 에서 볼 수 있으며, 여기서 다루는 문제들에 대한 더 자세한 논의를 찾을 수 있다.
개인의 후생에 기초해 사회후생을 정의하는 방법
우리는 개인들의 집합 i = 1, …, n의 후생에 기초해 사회후생을 평가한다. 여기서부터 벌써 첫 번째 어려운 질문들이 생긴다. 이 개인들의 집합에 누구를 포함해야 하는가? 많은 논의는 어떤 주어진 "사회"를 고려한다고 암묵적으로 가정한다. 그런데 이는 특정 시민권을 가진 모든 사람을 뜻하는가, 아니면 특정 영토에 사는 모든 사람을 뜻하는가? 왜 살아 있는 모든 인간은 아닌가? 다른 나라 사람들은 아무것도 고려하지 않아도 되는가? 미래 세대는 어떤가? 동물은 어떤가?
개인들의 집합이 정해지면, 다음으로 그들의 후생을 어떻게 측정할지 정해야 한다. 목표는 각 개인 i에게 그가 얼마나 잘 지내는지를 나타내는 수 Vi를 부여하는 것이다. 상황에 따라 이 수를 더 강하게 해석할 수도 있고 더 약하게 해석할 수도 있다. 서수적(ordinal) 해석은 Vi가 더 작은지 큰지만 고려한다. 기수적(cardinal) 해석은 Vi의 실제 크기에 관심을 둔다. 그 중간의 해석은 Vi가 변화하는 크기를 고려한다. 또 Vi는 사람들 사이에 비교할 수 있을 수도 있고 그렇지 않을 수도 있다. 비교할 수 있다면 Vi가 Vj보다 크다, 즉 i가 j보다 잘 지낸다고 말하는 것이 의미를 갖는다.
개인 후생 Vi를 어떻게 측정할지도 다시 여러 어려운 질문을 불러온다. 최소한의 개념은 개인이 누리는 형식적인 법적 권리만 고려할 것이다. 더 넓은 개념은 교육, 소득, 건강처럼 개인이 자신의 목표를 이룰 수 있게 해 주는 다양한 자원까지 고려할 수 있다. 기회(opportunities)에 대한 포괄적인 개념은 개인의 선택지에 영향을 주는 모든 요인을 고려해, 그들이 실제로 누릴 수 있는 선택지를 평가하려 할 것이다. 마지막으로 개인이 실제로 달성한 결과를 고려할 수도 있다. 이 결과는 어떤 공통 기준으로 평가할 수도 있고, 각 개인의 선호로 평가할 수도 있다. 후생경제학(welfare economics)에서 가장 흔한 관점인 공리주의(utilitarianism)는 개인이 실제로 달성한 결과를 개인의 선호에 따라 평가함으로써 개인 후생을 판단한다.
개인들의 집합 i와 그들의 후생에 대한 평가 Vi가 주어지면, 마지막으로 사회 전체가 얼마나 잘 지내는지를 묻는다. 형식적으로는 다음과 같은 "사회후생함수(social welfare function)"를 고려한다.
F(V1, …, Vn). (5)
함수 F는 우리가 각 개인을 얼마나 중시하는지를 정한다. 이 단계에서 모든 사람은 여전히 "이름"을 갖고 있다는 점에 유의하자. 함수 F는 j의 후생에 비해 i의 후생에 얼마만큼의 가중치를 줄지 알려 준다. 이 함수는 서로 다른 사람들을 똑같이 취급하고 이름을 신경 쓰지 않을 수도 있다. 그런 경우에도 이 함수는 가난한 사람과 부유한 사람, 아픈 사람과 건강한 사람에게 돌아가는 추가 1달러를 각각 얼마나 중시하는지 알려 준다. 이런 차이는 Vi의 수준에 영향을 주기 때문이다. 또한 함수 F는 이름이 아니라 개인의 어떤 특성에 따라 달라질 수도 있다. 예를 들어 인종, 성별, 부모의 지위가 개인의 후생을 결정해서는 안 된다는 믿음을 이 함수에 반영할 수 있다.
개인의 후생 Vi (i = 1, …, n)의 함수로 사회후생 F를 평가하는 이 개인주의적 틀은 매우 일반적이다. 이 틀은 급진적인 관점이든 보수적인 관점이든 다양한 관점과 양립한다. 그렇지만 몇 가지 제약을 부과하는데, 특히 파시즘적/완전주의적(perfectionist) 규범적 접근과 자유지상주의적(libertarian) 규범적 접근은 배제된다. 파시즘적 접근은 관련된 개인들이 어떤 대가를 치르든 국가의 위대함을 목표로 내세운다. 이와 비슷하게 완전주의적 관점은 문화적 생산, 과학 등에서의 위대함을 목표로 삼으며, 이 역시 개인의 후생과는 무관하다. 한편 자유지상주의적 접근은 어떤 결과가 사유재산, 계약, 시장에서의 자발적 교환에서 비롯된 것이기만 하면, 그것이 개인의 후생이나 불평등에 어떤 결과를 낳든 정의롭다고 본다. 자유지상주의적 접근과 후생에 기초한 접근 사이의 이 대비는 아래 3.1절에서 알고리즘 공정성(algorithmic fairness)을 논의할 때 다시 다룰 것이다.
개인 후생을 측정하는 방법
여기서는 개인 후생을 측정하는 두 가지 방식을 살펴본다. 첫째 방식은 후생을 "효용(utility)"과 같은 것으로 보고, 효용이 개인이 선택을 통해 최대화하는 것이라고 가정한다. 둘째 방식은 후생을 개인이 자신의 목표를 이루는 데 쓸 수 있는 자원("기본재(primary goods)")으로 측정하거나(그 목표가 무엇이든 상관없다), 개인이 목표를 추구할 때 부딪힐 수 있는 모든 제약을 고려하는 "역량(capabilities)"으로 측정한다.
효용으로 개인 후생을 평가하는 것은 경제학에서 단연 가장 흔한 접근이다. 이 접근에는 두 가지 주요 요소가 있다. 첫째는 원소 c로 이루어진 선택 집합(choice set) Ci다. 이 선택 집합은 개인이 마주한 모든 제약을 고려했을 때 실제로 고를 수 있는 모든 선택지를 나타낸다. 둘째는 효용함수(utility function) ui(c)로 표현되는 개인의 선호다. 개인은 가장 큰 효용을 주는 원소 c ∈ Ci를 선택한다고 가정한다. 그에 해당하는 효용 수준을 개인 후생의 척도로 삼으므로 다음과 같다.
Vi = maxc ∈ Ciui(c). (6)
이 틀에서 효용은 두 가지 역할을 한다는 점에 유의하자. 효용은 (i) 개인이 선택할 수 있을 때 최대화하는 대상이고, (ii) 사회후생의 관점에서 그 개인에게 바람직하다고 여겨지는 것이다. 일반적으로 효용함수 ui에 담긴 선호는 정책이나 기술과 무관하게 주어진다고 가정하는 반면, 선택 집합 Ci는 정책이나 기술의 영향을 받을 수 있다고 본다. 서로 다른 정책은 그 정책 아래서 개인이 달성할 수 있는 후생 Vi를 기준으로 비교할 수 있다.
효용이라는 개념에 어떻게 경험적 내용을 부여할 수 있을까? 효용은 관찰할 수 없지만 선택은 관찰할 수 있다. 이 틀에서는 선택이 효용을 최대화한다고 가정한다. 이 가정을 활용하면 "동등변화(equivalent variation)"라는 개념을 정의할 수 있다. 동등변화는 효용을 화폐 단위로 측정한다. 이는 선택 집합의 어떤 변화가 가져오는 것과 같은 크기의 효용 Vi 변화를 낳는 불로소득(unearned income)의 변화에 해당한다. 간단한 예를 들어 보자. 3유로를 받겠는가, 사과 두 개를 받겠는가? 둘 중 무엇을 받아도 상관없다면, 사과 두 개를 받는 것의 동등변화는 3유로다. 더 일반적으로, 좀 더 흥미로운 정책 변화에 대한 소득의 동등변화는 관찰된 선택으로부터 추론할 수 있다. Mas-Colell et al. (1995)의 3장을 참고하라. 이 접근을 쓰면 개인에게 미치는 후생 효과를 화폐 단위로 계산할 수 있다. 그렇게 하고 나면, 사회후생에 대해 말하기 위해 남은 일은 서로 다른 사람들에게 돌아가는 추가 1유로(또는 1달러 등)를 각각 얼마나 중시할지 정하는 것이다.
공리주의적 접근은 어떤 개인이 선택할 수 있다면 무엇을 고를지에 근거해, 그 개인에게 무엇이 더 좋고 무엇이 더 나쁜지를 평가할 수 있게 해 준다. 특히 이 접근에 따르면 선택지가 더 많은 것(즉 선택 집합 Ci가 더 큰 것)이 일반적으로 더 좋다. 그러나 적어도 현시선호(revealed preference)에 근거해서는 사람들 사이의 효용을 비교할 수 없다. 그런데 이런 비교를 할 수 있어야 규범적 관점에서 불평등을 논할 수 있다.
우리가 관찰하고 사람들 사이에 비교할 수 있는 것은 그들이 쓸 수 있는 자원, 그리고 그들이 실제로 할 수 있는 선택에 영향을 주는 자원이다. 자원이 많을수록 대체로 선택지가 많아지고 따라서 효용도 높아진다. 이러한 자원을 고려하는 것은 Rawls (1973)의 핵심 아이디어 가운데 하나로, 롤스는 이를 기본재라고 부른다. 그는 건강, 시민적·정치적 권리, 소득과 부, 자존감의 사회적 기반이 개인 후생을 측정하는 기본재에 포함되어야 한다고 주장한다. 이 접근을 쓰면 자원 면에서 누가 더 잘 지내고 누가 더 못 지내는지, 따라서 평등이 달성되었는지를 말할 수 있다.
롤스의 뒤를 이어 Sen (1995)은 이와 비슷한 개념을 발전시켰다. 센은 후생의 핵심 척도가 "기능할 수 있는 역량(capabilities to function)"이라고 주장한다. 역량은 고정된 자원 목록이나 기본재 목록에 기초하지 않는다. 그 대신 모든 법적·사회적·경제적·문화적 제약을 고려해, 개인이 실제로 쓸 수 있는 선택지를 포괄적으로 측정한다. 이러한 역량은 앞서 공리주의적 후생을 논의하면서 도입한 집합 Ci와 상당히 비슷하다.
사람들 사이에서 후생을 어떻게 저울질할 것인가
개인 후생을 어떤 방식으로 측정하든, 규범적 판단을 내리려면 개인 후생을 사회후생으로 집계해야 한다. 이 집계는 어떤 함수 F가 맡는다.
어떤 정책을 조금 바꾸는 경우를 생각해 보자. 이 변화는 각 개인의 후생 Vi에 그에 상응하는 작은 변화 dVi를 가져온다. 이때 집계를 후생 가중치(welfare weights) ωi로 생각하면 유용하다. 사회후생은 F(V1, …, Vn)이라는 점을 떠올리자. F가 미분 가능하다고 가정하고 ωi ≔ ∂/(∂Vi)F(V1, …, Vn)이라 하자. 그러면 미분을 통해 사회후생의 변화 dF를 다음과 같이 계산할 수 있다.
dF = Σiωi · dVi, (7)
여기서 dVi는 정책 변화가 개인 i의 후생에 미치는 효과이고, ωi는 사회후생을 계산할 때 개인 i의 후생에 부여하는 가중치를 나타낸다. Saez and Stantcheva (2016)를 참고하라.
후생을 개인의 효용으로 평가할 때 dVi는 흔히 화폐 단위(예컨대 유로 금액)로 표현된다. 앞서 논의했듯이 이때 변수 dVi를 동등변화라고 부른다. dVi를 화폐 단위로 측정하면, 비율 ωi/ωj는 개인 j에게 돌아가는 추가 1유로에 비해 개인 i에게 돌아가는 추가 1유로를 얼마나 중시하는지를 나타낸다. 평등주의적(egalitarian) 입장은 사회에서 가장 형편이 나쁜 사람들에게 큰 가중치 ω를 부여한다. 더 일반적으로, 가난한 사람과 부유한 사람의 후생 가중치 비율은 어떤 집계가 얼마나 평등주의적인지를 재는 척도로 볼 수 있다. 원래 구상된 형태의 공리주의는 소득의 한계효용(marginal utility)이 소득이 늘수록 줄어든다고 가정하며, 따라서 형편이 나쁜 사람들에게 더 높은 가중치를 둔다. 이러한 집계와 달리 법경제학(law and economics) 분야에서 쓰이는 일부 모형은 사람들의 유로 금액을 그냥 합산하며, 따라서 모든 사람의 추가 소득에 같은 가중치를 부여한다(Liscow, 2018). 억만장자에게 돌아가는 추가 1유로를 굶주리는 사람에게 돌아가는 추가 1유로와 같은 것으로 보는 셈이다. 이런 집계는 매우 반평등주의적이다.
후생 가중치를 "거꾸로" 생각해 볼 수도 있다. 한 사회에서 실제로 이루어진 정책 선택이 주어지면, 그 정책 선택을 정당화하는 후생 가중치의 집합이 그에 대응해 존재한다. 이러한 가중치는 실질적인 사회 권력(effective social power), 곧 기성 권력이 누구의 이익을 대변하는지를 보여 주는 척도로 볼 수 있다.
2.3 변화의 주체와 민주적 거버넌스
앞 절에서는 서로 충돌하는 여러 목표를 가진 개인들로 이루어진 사회에서 기술과 정책을 규범적으로 평가하는 문제를 다루었다. 이런 규범적 평가가 실제로 의미를 가지려면, 사회 변화를 어떻게 일으킬지에 대한 전략적 전망이 함께 있어야 한다. 그렇다면 사회 변화를 이끌 잠재적 주체는 누구인가? 변화의 주체(agents of change) 문제는 지난 한 세기 동안 정치이론에서 많이 논의되어 왔다(e.g. Wright, 2019, chapter 6). 이 질문은 여러 형태로 던질 수 있다. 어떤 주체가 기술과 정책을 움직일 이해관계, 가치, 역량을 갖고 있는가? 어떤 주체가 어떤 정의 개념에 비추어 사회후생을 높이는 방향으로, 예컨대 형편이 나쁜 사람들의 복리를 개선하는 방향으로 기술과 정책을 움직일 수 있는가? 마지막으로, 어떤 단일 행위자나 조직도 혼자서 변화를 일으킬 만큼 강하지 않은 분열된 세계에서, 헤게모니적 행위자를 중심으로 동맹과 연합을 어떻게 구축할 수 있는가? 이때 연합 안의 행위자들은 이해관계와 가치를 공유하고 공동의 정체성을 키워 간다(Gramsci, 1947).
변화를 일으킬 힘에 관한 이러한 도구적 또는 전략적 관점과 밀접하게 연결된 것이 민주주의와 기술에 대한 통제라는 규범적 질문이다. 예컨대 경제민주주의(economic democracy)를 다룬 Wright (2019)의 4장을 보라. AI의 목표를 사회후생과 일치시키려면 AI의 목적함수(objective function)에 대한 통제권이 폭넓게 공유되어야 한다. 행위자들이 자기 이익에 따라 행동한다면 더욱 그렇다.
이윤 극대화, 변화의 주체, 위협점
AI의 개발, 배치, 규제를 사회적으로 이로운 방향으로 이끌 수 있는 변화의 잠재적 주체는 누구인가?³ AI의 사회적 영향에 관한 담론의 상당 부분은 기업의 자발적인 윤리적 행동에 초점을 맞춘다. 여기에는 기업 경영자나 엔지니어가 더 공정한 사회를 향한 변화의 주체로 행동할 것이라는 암묵적 가정이 깔려 있다.
³ 이하의 논의는 앞서 Abebe and Kasy (2021)에서 제시한 주장에 기초한다. https://www.bostonreview.net/forum_response/the-means-of-prediction/
이러한 접근은 주류 경제학, 좌파 정치이론, 신자유주의 사상이 공유하는 전제와 대조된다. 그 전제란 민간 기업은 무엇보다 이윤을 극대화하는 주체라는 것이다. 이 전제가 옳다면, 기업 의사결정자의 윤리에 초점을 맞추는 접근은 가능한 변화의 범위를 필연적으로 아주 좁게 한정한다. AI를 사회적으로 이로운 방향으로 규제하려는 기업의 자발적 행동은 그 행동이 이윤 극대화와 부합해야만 가능하다. 민간 기업이 주로 이윤을 극대화한다면, 윤리적 고려는 겉치레에 그치거나 도구적인 역할만 하게 된다. 이런 도구적 역할은 (실체가 잘 잡히지 않는) "다양성의 비즈니스 논리(business case for diversity)"를 반영할 수도 있고, 차별금지 소송, 노동조합 조직화, 나쁜 언론 보도, 소비자 불매운동, 정부 규제를 피하려는 행동일 수도 있다.
이는 기술적 결정이 민간 기업 안에서 내려지는 세계에서 변화를 이끌어 낼 수 있는 경로를 시사한다. 외부 압력이 이윤 극대화를 사회후생과 더 잘 맞물리게 하는 방향으로 작용해야 한다. 이러한 압력이 기업의 계산에서 의미 있는 역할을 하려면 외부의 규제, 옹호 활동(advocacy), 감독이 필요하다. 다시 말해, 기업 바깥에서 새로운 기술이 일으킬 수 있는 문제를 인식하고, 그 기술이 사회 구성원 모두에게 어떤 영향을 미치는지 이해하며, 규범에 영향을 미치고 유인을 바꾸고 직접 행동에 나서 개발의 방향을 바꿀 수 있는 행위자가 필요하다. 잠재적 행위자는 많고, 이들이 취할 수 있는 행동의 형태도 많다. 이 행동들은 Hirschman (1986)이 논의한 "이탈(exit)"과 "항의(voice)"의 두 범주에 모두 걸쳐 있다. 파업이라는 잠재적 지렛대를 가진 노동자 조직과 노동조합이 있다. 대중의 관심과 소비자 불매운동이라는 잠재적 지렛대를 가진 시민사회 행위자, 비정부기구, 언론인이 있다. 그리고 과세, 입법, 소송이라는 지렛대를 가진 정부 정책결정자, 사법부, 규제 기관, 정치인이 있다. 이 모든 행위자는 AI를 사회적으로 더 이로운 미래로 이끄는 어떤 전략에서든 반드시 필요한 역할을 맡는다.
민주적 거버넌스와 예측 수단
방금 제시한 논증은 전략적 논증이다. 즉 AI의 목표가 사회후생과 일치하도록, 이해관계와 가치가 사회의 폭넓은 기반과 맞닿아 있는 행위자들에게 호소하고 그들에게 힘을 실어 주어야 한다는 것이다. 이윤 극대화라는 목표(또는 다른 좁은 이해관계)에 묶인 행위자는 구조적으로 후생을 폭넓게 개선하는 기술적 선택을 할 수 없다.
이 전략적 또는 도구적 논증은 좀 더 직접적인 규범적 논증과 이어진다. 자기결정(self-determination), 즉 자신의 운명을 스스로 결정하는 능력은 그 자체로 목표다. 그리고 복잡하게 상호의존하는 사회에서 자기결정이 실효성을 가지려면 개인 수준을 넘어서야 한다. 달리 말하면, 사회의 여러 수준에서 실현되는 민주주의는 우리가 지향해야 할 목표다. 역사적 우연이라고 볼 만한 이유로, 근대 사회는 정치의 영역과 경제의 영역을 분리하는 경향이 있다. 정치 영역의 민주주의는 정치적 스펙트럼 전반에서 폭넓게 지지받는 목표다. 반면 경제 영역에서는, 특히 영어권 세계에서, 금권정치(plutocracy)가 폭넓게 받아들여진다. 깨어 있는 시간 가운데 고용 관계 속에서 보내는 시간 동안, 자본을 소유한 사람들의 의사결정 권한은 거의 의문시되지 않는다. 그래서 민주화 프로젝트는 아직 끝나지 않았으며, 좋은 사회라면 민주주의를 좁은 의미의 정치 영역 너머로, 우리 삶에 중요한 영향을 미치는 다른 영역으로까지 확장해야 한다는 주장이 제기되어 왔다(e.g. Wright, 2019, chapter 4). Sandel (2022)도 참고하라. 이러한 관점이 AI에 대해 시사하는 바는, 자동화된 의사결정 시스템의 목적을 두고 민주적 토론과 통제가 이루어져야 한다는 것이다. 이러한 통제는 특히 그 시스템의 결정으로부터 중대한 영향을 받는 사람들이 행사해야 한다. 또한 정기 선거라는 맥락에서 국민국가 차원에서만 행사될 것이 아니라, 사회의 여러 층위에서 행사되어야 한다. 2.1절에서 논의했듯이 자동화된 의사결정의 목적을 민주적으로 통제하려면, 다시 데이터와 연산 인프라를 포함한 "예측 수단(means of prediction)"에 대한 민주적 통제가 필요하며, 자동화된 의사결정 시스템이 어떻게 작동하는지에 대한 기본적인 이해도 필요하다. 이윤 극대화라는 제약 아래 있는 행위자들의 윤리 의식에 호소하는 것만으로는 충분하지 않다. 최악의 피해를 막는 데만 초점을 맞춘 최소한의 규제적 제약도 충분하지 않다. 아래에서 논의할 제안인, 데이터에 대한 개인 수준의 재산권 역시 마찬가지다. 이 장의 나머지 부분에서는 AI의 윤리와 사회적 영향을 둘러싼 여러 논쟁의 맥락에서 이러한 관점을 구체적으로 전개한다.
3 AI의 윤리와 사회적 영향
개념적 틀에 대한 검토를 마쳤으니, 이제 AI의 윤리와 사회적 영향을 둘러싼 논쟁으로 넘어가자. 이 논쟁들은 (i) 공정성, 차별, 불평등, (ii) 프라이버시, 데이터 재산권, 데이터 거버넌스(data governance), (iii) 가치 정렬(value alignment)과 임박한 로봇 종말, (iv) 자동화된 의사결정의 설명 가능성(explainability)과 책임성(accountability), (v) 자동화, 그리고 AI가 노동시장과 임금 불평등에 미치는 영향에 관한 것이다. 이 논쟁들을 포괄적으로 검토하기보다는, 2절에서 세운 틀을 바탕으로 각 논쟁을 간략히 정리하려 한다. 그런 다음 각 논쟁을 AI의 목적, 사회후생, 민주적 거버넌스에 관한 앞선 논의와 다시 연결할 것이다.
3.1 공정성과 불평등
자동화된 의사결정을 두고 제기되는 우려 가운데 하나는 그 결과로 나온 결정이 공정한지, 거꾸로 말하면 의사결정 시스템이 차별적인지 여부다.⁴ 알고리즘 공정성(algorithmic fairness) 논의의 표준적인 설정은 2.1절에서 다룬 표적 처치 배정(targeted treatment assignment)이다. 다시 떠올려 보면, 이 설정에서 알고리즘은 처치 배정 정책 W = h(X)를 산출하며, 관측 가능한 특성 X의 함수로 처치 W를 배정한다. 이진 처치의 경우 전형적인 목적은 처치받은 사람들 사이에서 처치 비용 c를 뺀 결과 Y의 합, 즉 E[h(X) · (Y − c)]를 극대화하는 것이다. 예를 들어 채용의 맥락에서 W는 노동자를 채용할지에 대한 결정이고, Y는 그 노동자의 생산성(기업 이윤에 대한 기여)을 나타내는 어떤 척도이며, c는 그 노동자의 임금이다.
⁴ 이 절의 논의는 Kasy and Abebe (2021)에 기반한다.
공정성
정책 h(X)가 공정하다거나 차별적이라는 것은 무엇을 뜻하는가? 문헌에서는 서로 다른 정의가 많이 제안되었고, 그중 일부는 수학적으로 서로 양립할 수 없다. 그러나 이 정의들 중 다수는 개념적으로 밀접하게 연결되어 있으며, 경제학의 선호 기반 차별(taste-based discrimination) 개념과 비슷하다. 특히 전형적인 정의들은 이윤처럼 의사결정자의 목적에 해당하는 어떤 "능력(merit)" 개념 Y와, 인종이나 성별처럼 두드러진 정체성 집단 A에 기반한다. 집단 간에 처치받을 확률이 불평등하고, 그 불평등이 집단 간 "능력"의 차이로 정당화되지 않는다면, 그 배정 정책은 불공정한 것으로 규정된다. 이러한 공정성 정의 가운데 하나인 "예측 동등성(predictive parity)"은 다음 차이가
E[Y | W = 1, A = 1] − E[Y | W = 1, A = 0]
0이 될 것을 요구한다. 말로 풀면, 처치받은 사람들의 평균 능력이 집단 A = 1과 A = 0에서 같아야 한다는 것이다. 이 조건은 실증경제학에서 "선호 기반 차별에 대한 적중률 검정(hit rate test for taste-based discrimination)"으로도 알려져 있다(Knowles et al. (2001) 참조). 이와 밀접하게 관련되고 같은 한계를 공유하는 다른 정의로는 "참양성 동등성(equality of true positives)", "거짓양성 동등성(equality of false positives)", "음성 집단에 대한 균형(balance for the negative class)" 등이 있다. 이른바 "개인 공정성(individual fairness)" 개념들도 이와 관련된다. 공정성 정의에 대한 포괄적인 검토로는 Pessach and Shmueli (2020) 등을 참조하라.
Kasy and Abebe (2021)에서 주장했듯이, 이런 형태의 정의들에는 여러 규범적 한계가 있다.
- 이 정의들은 집단 내부와 집단 사이에서 "능력"으로 정당화되는 불평등을 정당화하고 영속화한다. 의사결정자의 목적을 증진하는 척도인 "능력"에 초점을 맞추면, 현상 유지(status quo)의 정당성을 문제 삼기보다 오히려 강화하게 된다.
- 이 정의들은 좁게 한정되어(narrowly-bracketed) 있다. 공정성은 해당 알고리즘의 맥락 안에서만 동등한 처우를 요구할 뿐, 그 알고리즘이 더 넓은 인구 집단의 후생 불평등에 미치는 영향은 고려하지 않는다. 기존의 불평등을 보상하는 불평등한 처우는 오히려 후생 불평등을 줄일 수도 있다.
- 이 정의들은 범주(보호 집단)에 초점을 맞추고, 특히 교차성(intersectional) 비판이 강조해 온 집단 내 불평등을 무시한다(Crenshaw, 1990). 집단 간 동등한 처우는 집단 내의 큰 불평등과 얼마든지 양립할 수 있다.
이러한 한계와 밀접하게 관련된 사실이 있다. 예측 동등성 같은 공정성 정의는 사실상 차별을 이윤 극대화로부터의 이탈과 동일시한다는 점이다. 결과 Y를 완벽하게 예측할 수 있다면, 이윤을 극대화하는 정책 h(X)는 그로 인한 배분이 집단 A 사이에서든 내부에서든 후생 측면에서 아무리 불평등하더라도 자동으로 공정성을 충족한다. 예를 들어 Y가 이진 변수이고 X가 주어졌을 때 완벽하게 예측 가능하다면, W = h(X) = Y는 이윤을 극대화하며, 예측 동등성은 물론 음성 집단에 대한 균형, 참양성 및 거짓양성 동등성 등도 충족한다.
이는 우연이 아니다. 선호 기반 차별에 대한 정의들의 기원에는 Becker (1957)의 연구가 있다. 이 연구는 규범적 바람직함을 경쟁 시장에서 이윤을 극대화하는 기업의 결정과 동일시했으며, 그 결정의 영향을 받는 사람들의 후생에 어떤 결과가 생기는지와는 무관하게 그렇게 했다. 이러한 공정성 및 차별 개념은 암묵적으로 자유지상주의적(libertarian) 규범 틀에 기반한다. 이는 앞의 2.2절에서 논의한 결과주의적(consequentialist) 사회후생 개념과 대조된다. Becker의 의미에서 공정성이란, 어떤 사회후생 개념 F(V1, …, Vn)를 극대화하는 정책이 아니라 이윤 목적함수 E[h(X) · (Y − c)]를 극대화하는 처치 배정 정책을 고르는 것에 해당한다.
평등과 사회후생
사회후생의 관점에서 우리가 관심을 두는 것은 정책 h(X)가 개인의 후생 Vi와 총후생 F(V1, …, Vn)에 미치는 영향이다. 이 영향을 형식적으로 논의하기 위해 인과추론의 잠재적 결과 틀(potential outcomes framework)을 생각해 보자(Imbens and Rubin, 2015). 이진 처치 Wi를 고려하고, 개인의 후생 Vi가 결정될 때 개인 간 파급효과(spillover)가 없다고 가정하자. 그러면 개인의 후생이 다음과 같은 잠재적 결과 방정식으로 결정된다고 가정할 수 있다.
Vi = Wi · Vi1 + (1 − Wi) · Vi0. (8)
말로 풀면, 개인 i가 처치를 받으면 그의 후생은 Vi1이고, 그렇지 않으면 Vi0이다. X를 처치받을 확률 h(X)로 대응시키는 처치 배정 정책 h는 어떤 것이든, 특성 X와 결합된 다음과 같은 후생의 실현 분포를 함축한다.
pV, X(v, x) = [pV0 | X(v, x) + h(x) · (pV1 | X(v, x) − pV0 | X(v, x))] · pX(x).
그러면 전형적인 사회후생함수 F는 이 분포의 함수로 쓸 수 있다.
이는 2.2절에서처럼 처치 배정 정책이 사회후생에 미치는 영향을 평가하기 위한 일반적인 서술이다. 이것이 앞에서 논의한 공정성 개념과 어떻게 다른지 다시 한번 강조해 두자. 공정성은 (i) 같은 "능력"을 가진 사람들이 (iii) 소속 집단과 무관하게 (ii) 처우받을 것을 요구하는 것이다. 사회후생은 알고리즘이 (iii) 서로 다른 사람들의 (ii) 후생 분포에 대해 갖는 (i) (반사실적/인과적) 결과에 관한 것이다. 이 두 개념이 서로 상충하는 규범적 평가를 내리는 상황은 많다. 한 가지 예는 감시가 강화되거나 예측 알고리즘이 더 좋아지는 경우의 결과다. 일반적으로 예측이 더 정확해지면 처우가 "능력"에 더 잘 맞춰지므로 공정성에는 좋다. 그러나 동시에 처우가 더 불평등해지므로 평등과 사회후생에는 대개 나쁘다. 또 다른 예는 적극적 우대 조치(affirmative action), 재분배, 기존 불평등에 대한 보상적 개입 등 모든 형태의 조치다. 이러한 개입은 앞에서 정의한 공정성에는 언제나 나쁘지만, 평등과 사회후생에는 좋다.
이 논의에서 인공지능 규제에 대해 얻을 수 있는 핵심 교훈은 다음과 같다. 자동화된 의사결정 시스템을 평가할 때는 대개 이윤 극대화와의 일치를 요구하는 공정성보다, 개인과 사회의 후생에 미치는 결과에 더 초점을 맞춰야 한다. 노동조합, 시민사회단체, 공공 정책결정자가 감사(auditing)와 통제를 하는 메커니즘은 후생에 미치는 결과를 평가하는 도구에 기댈 필요가 있다. 이러한 도구에는 무엇보다 실증경제학 등의 분야에서 발전해 온 인과추론과 후생 측정이 포함된다.
3.2 프라이버시와 데이터 거버넌스
기계학습이 학습을 하려면 목적함수, 학습 알고리즘, 그리고 데이터가 필요하다. 지도학습(supervised learning)에 관한 2.1절의 표기법에서 데이터는 흔히 관측치 (Xi, Yi)의 형태를 띠며, 여기서 i는 서로 다른 개인을 가리키는 첨자다. 기계학습이 사회적으로 중대한 결과를 낳는 여러 영역에 들어오면서 프라이버시 문제가 가장 중요한 문제로 떠올랐다. 누가 개인에 관한 어떤 종류의 데이터에 접근하고 그것을 통제하는가? 개인은 그러한 접근을 어느 정도까지 실질적으로 거부할 수 있는가? 데이터 수집으로 인해 개인에게 생기는 피해는 어떻게 막을 수 있는가?
컴퓨터과학에서 프라이버시를 형식화하는 대표적인 방식은 차등 프라이버시(differential privacy)다. 아래에서는 먼저 이 형식화를 검토하고 그 장점과 한계를 논의한다. 차등 프라이버시는 본질적으로, 이후에 무슨 일이 일어나든 개인이 자신의 데이터가 수집되는지 여부에 대해 무차별(indifferent)하다는 것을 보장한다. 따라서 차등 프라이버시가 보장된다면, 개인이 개인적 데이터 재산권(data property rights)을 근거로 자신의 데이터 수집에 반대할 수 있다 하더라도 그렇게 할 이유가 없다.
그다음으로 이 접근법의 한계를 논의한다. 차등 프라이버시는 개인 i 자신의 데이터 수집으로 인해 그 개인에게 피해가 생기지 않도록 실질적으로 보장하지만, 사람들의 데이터 수집으로 인해 사람들의 집단에 피해가 생기지 않도록 보장하지는 않는다. 그 이유는 "데이터 외부효과(data externalities)" 때문이다. 기계학습은 개별 사례가 아니라 패턴을 학습하는 일이다. 차등 프라이버시와 개인적 재산권은 이러한 패턴의 학습을 막지 못하며, 따라서 그로부터 뒤따르는 피해도 막지 못한다. 그러므로 아래에서 논의하듯이, 데이터 수집에서 생기는 피해는 민주적 데이터 거버넌스를 통해서만 막을 수 있다.
차등 프라이버시
(Xi, Yi) 형태의 항목들로 이루어진 데이터베이스 𝒳를 생각해 보자. 이 데이터베이스에 포함된 사람들의 신원을 드러내지 않으면서, 𝒳에 관한 유용한 정보를 제3자에게 공개하려면 어떻게 해야 할까? 이 질문에 답을 제시하는 차등 프라이버시는 컴퓨터과학에서 잘 연구되어 있고 일관된 프라이버시 접근법이다(Dwork and Roth, 2014). 이 접근법은 일부 정보를 공개하면서 프라이버시를 지키려던 이전 시도들의 한계에 대한 대응으로 이해할 수 있다. 프라이버시에 대한 소박한 접근법들은 대개 보조 정보(auxiliary information)에 취약하다. 그런 접근법 가운데 하나는 이름, 주소, 사회보장번호 같은 "식별 정보"를 제거하는 것이다. 이 접근법의 문제는 겉보기에 무해한 변수 몇 개만으로도 개인을 고유하게 식별하기에 충분한 경우가 많다는 점이다. 예를 들어 어떤 사용자가 스트리밍 플랫폼에서 최근 본 영화 목록만으로도 그 사용자가 고유하게 식별될 가능성이 높다. 흔히 쓰이는 또 다른 접근법은 집계(aggregation)로, 사람들의 집단별 변수 평균만 보고하는 방식이다. 이 경우에도 여러 변수의 평균이 보고되면 그 집계에 포함된 개인을 식별하는 일은 놀라울 만큼 쉽다. 눈에 띄는 예로, 특정 질병을 가진 환자들 사이의 유전 변이("단일 염기 다형성(single nucleotide polymorphisms)") 빈도를 보고하는 의학 연구가 있다. 유전자 수가 충분히 많다면 이러한 집계 빈도로부터 표본에 포함된 모든 환자의 신원을 복원할 수 있고, 그 결과 그들이 특정 질병을 앓고 있다는 사실이 드러날 수 있다.
"차등 프라이버시"는 이러한 함정을 피하는 일관되고 견고한 정의를 제공한다. 차등 프라이버시는 데이터베이스 𝒳를 무작위 보고(report) ℳ(𝒳)로 대응시키는 무작위 알고리즘 ℳ을 다룬다. 여기서 보고란 데이터 𝒳에 대한 어떤 서술이나 요약이든 될 수 있으며, 예컨대 기계학습 알고리즘이 산출한 요약도 이에 해당한다. 한 개인 i의 데이터 (Xi, Yi)가 추가되거나 제거되었다는 점만 빼면 똑같은 두 데이터베이스 𝒳와 𝒳'을 생각해 보자. 가능한 보고들의 모든 집합 𝒮에 대해, 그리고 항목 하나만 다른 모든 𝒳와 𝒳'에 대해 다음이 성립하면, 무작위 알고리즘 ℳ은 ε-차등 프라이버시를 갖는다(ε-differentially private)고 말한다.
(P(ℳ(𝒳) ∈ 𝒮))/(P(ℳ(𝒳') ∈ 𝒮)) ≤ exp(ε). (9)
ε이 작다면, 이는 항목 하나만 다른 어떤 데이터베이스 쌍에 대해서도 ℳ(𝒳)와 ℳ(𝒳')의 확률분포가 거의 같다는 뜻이다. 즉 특정 개인이 데이터에 포함되든 포함되지 않든 눈에 띄는 차이가 생기지 않는다. 차등 프라이버시를 갖는 알고리즘은 모두 무작위성을 사용해야 한다. 무작위성이 없다면, 자명한 경우를 제외하고는 항목 하나만 다르면서 ℳ(𝒳) ≠ ℳ(𝒳')인 데이터베이스 쌍 𝒳와 𝒳'이 언제나 존재한다.
이러한 프라이버시 정의에는 바람직한 성질이 여럿 있다. 가장 중요한 것은 후처리(post-processing)에 영향을 받지 않는다는 점이다. 누군가 어떤 추가 데이터를 갖고 있든, 보고된 ℳ(𝒳)에 어떤 계산을 적용하든, 그 결과로 나온 보고는 여전히 ε-차등 프라이버시를 유지한다. 하나의 데이터베이스 𝒳에 기반해 여러 보고가 이루어진다면, 예컨대 각각 ε1과 ε2의 차등 프라이버시를 갖는 보고들이 나온다면, 프라이버시 손실의 상한은 더해진다. 즉 그 결과는 ε1 + ε2의 차등 프라이버시를 갖는다. 이로부터 주어진 "프라이버시 예산(privacy budget)"을 어떻게 쓸 것인가 하는 문제가 생긴다. 이 문제는 예컨대 최근 미국 인구조사를 둘러싼 논쟁에서 불거졌는데, 여러 사회과학자가 전체 프라이버시 예산 제약 아래에서 미국 인구에 관한 서로 다른 사실을 알아내고자 했다.
관련 정보를 드러내면서도 차등 프라이버시를 유지하는 무작위 알고리즘에 관해서는 방대한 문헌이 축적되어 있다. 이 장에서 특히 중요한 것은 차등 프라이버시를 갖는 기계학습 알고리즘이다. 2.1절에서 살펴본 기계학습 여러 분야의 목적을 떠올려 보자. 특성 X가 주어졌을 때 결과 Y를 예측하는 것(지도학습), 특성 X가 주어졌을 때 어떤 결과 Y를 극대화하도록 처치 W를 고르는 것(표적 처치 배정), 또는 결과 Y의 흐름을 극대화하도록 처치 W를 적응적으로 고르는 것(다중 슬롯머신(multi-armed bandits))이다. 결정적으로, 이 목적들은 모두 X, W, Y 사이의 어떤 모집단 수준의 관계를 학습할 것을 요구하지만, 그 어느 것도 데이터셋 안의 특정 개인의 데이터를 식별할 것을 요구하지는 않는다. 상당히 놀랍게도, 차등 프라이버시는 이러한 목적들에 대해 아주 적은 비용만을 부과하는 것으로 밝혀졌다(Dwork and Roth (2014), 11장 참조). 달리 말하면, 기계학습이나 그로부터 뒤따르는 어떤 결과에도 영향을 주지 않으면서 차등 프라이버시를 유지할 수 있다.
재산권, 데이터 외부효과, 민주적 데이터 거버넌스
차등 프라이버시는 특정 개인이 데이터에 포함되든 포함되지 않든 관측 가능한 차이가 (거의) 없다는 것을 함축한다. 이로부터, ℳ(𝒳)에 기반한 제3자의 행동으로 영향을 받을 수 있는 개인에게도 자신이 데이터에 포함되는지 여부가 (거의) 아무런 차이를 만들지 않는다는 결론이 나온다. 이는 누가 질의 결과를 보게 되든, 그들이 어떤 다른 정보를 갖고 있든, 보고 ℳ(𝒳)에 기반해 어떤 행동을 하든 상관없이 성립한다(Dwork and Roth (2014), 10장 참조).
이 통찰은 차등 프라이버시 개념을 데이터에 대한 개인적 재산권을 둘러싼 밀접한 논쟁과 연결해 준다. 프라이버시 문제를 다루기 위한 한 가지 제안은 개인에게 자신에 관한 데이터를 통제할 법적 권리와, 그에 따라 이 데이터를 제3자에게 팔거나 서비스와 교환할 권리를 부여하자는 것이다. 이 아이디어는 특히 재런 래니어(Jaron Lanier) 등이 주창해 왔다. 앞의 논증에 따르면, 자기 데이터에 대한 재산권을 가진 개인들은 차등 프라이버시를 갖는 메커니즘에 자기 데이터를 공개하지 않을 유인이 없다.
데이터에 대한 개인적 재산권을 인정하는 법적 장치가 데이터 수집과 처리로 인해 생기는 피해로부터 개인을 보호해 줄 것이라는 생각은 그럴듯해 보일 수 있다. 그러나 다음 논증이 보여주듯 실제로는 그렇지 않다. 차등 프라이버시가 보장된다면 개인적 데이터 재산권은 데이터 수집을 줄이지 못할 것이다. 게다가 기계학습은 차등 프라이버시로 인해 사실상 아무런 제약도 받지 않으므로, 기계학습 기반 기술의 사용에서 생기는 피해나 편익은 차등 프라이버시나 개인적 재산권의 영향을 받지 않는다는 결론이 나온다. 경제학자들은 이 사실을 "데이터 외부효과"라고 불러왔다(Acemoglu et al. (2022) 참조). 개인이 자기 데이터를 공개하면, 그것이 차등 프라이버시를 갖는 메커니즘에 대한 공개라 하더라도 다른 개인들에게 결과를 미칠 수 있으며, 그 반대도 마찬가지다. 이러한 외부효과는 일종의 "죄수의 딜레마(prisoner's dilemma)"로 이어질 수 있다. 어떤 개인도 자기 데이터를 내놓지 않을 유인이 없지만, 집단적으로는 데이터 수집으로 모두가 피해를 입을 수 있다.
구체적인 예를 들어 보자. 한 건강보험 회사가 어떤 질병 Y에 대한 개인의 예측 특성(위험 요인) X에 관한 데이터를 수집한다고 하자. 여기서 예측 특성 X는 공개된 정보이지만, 질병 데이터는 프라이버시 제한의 대상이다. 환자들이 차등 프라이버시 조건 아래에서 자기 데이터를 회사에 판다면, 받게 될 대가만큼 개인적으로는 이득을 본다. 그러나 그 결과 모든 고위험 환자의 보험료가 오르고, 이들의 처지는 더 나빠지며, 보험은 아마도 덜 공평해질 것이다.
이러한 피해는 그 구조상 개인 수준의 프라이버시 권리를 제정하는 것으로는 막을 수 없다. 오히려 Viljoen (2021)이 주장하듯, 이 피해는 어떤 형태의 집단적이고 민주적인 데이터 거버넌스를 통해서만 다룰 수 있다. 2.3절에서 논의했듯이 데이터 수집에 관해 집단적으로 숙의하고 결정하는 과정이 있어야만, 민간이나 공공 주체의 감시로 인한 피해를 막으면서도 AI와 기계학습이 줄 수 있는 잠재적 편익을 누릴 수 있다. 개인 데이터로부터 학습한 패턴에 기반한 자동화된 의사결정으로 영향을 받을 수 있는 사람들은 이 데이터의 수집에 대해 발언권을 가져야 한다. AI 규제의 중요한 과제는 예측 수단에 대한 이러한 집단적 숙의와 통제를 가능하게 하는 법적 환경과 조직 구조를 만드는 것이다.
3.3 가치 정렬과 이해관계의 충돌
2.1절에서 논의했듯이, AI는 일련의 보상(reward)을 극대화하는 시스템을 만드는 일과 관련된다. 이 일반적인 정의에 포함되는 접근법 중 하나가 강화학습(reinforcement learning)이다(Sutton and Barto (2018); François-Lavet et al. (2018) 참조). 강화학습에서 알고리즘은 마르코프 결정 문제(Markov Decision Problem)를 풀어야 하는데, 여기에는 시간에 따라 변화하는 환경의 내생적 상태가 존재한다. 알고리즘은 일련의 보상을 극대화하기 위해, 어떤 상태에서 다음 상태로 넘어갈 확률과 각 상태와 행동에 따른 보상의 분포를 학습해야 한다. 이 맥락에서, 그리고 AI의 다른 분야에서도 제기되는 문제가 바로 가치 정렬(value alignment)의 문제다(Russell, 2019).
[...] 우리는 가치 정렬의 실패를 겪을 수 있다. 즉, 어쩌면 의도치 않게, 우리 자신의 목표와 완전히 일치하지 않는 목표를 기계에 심어 넣을 수 있다.
이 문제를 보여주는 유명한 사고실험은 Bostrom (2003)이 제시했다. 그는 가능한 한 많은 종이 클립을 생산하라는 목표를 부여받은 가상의 AI를 상정했다. 인간은 종이 클립이 무한히 많아지기를 원하지 않으므로, 이 AI는 결국 인간이 자신을 끌 수 있는 가능성을 없애야 하며, 그 방법은 인간을 제거하는 것이다.⁵
이런 시나리오가 당장 가장 시급한 걱정거리는 아닐 수 있다. 하지만 보다 일상적인 상황에서 나타나는 같은 종류의 위험은 지금 이 순간에도 매우 현실적인 문제다. 한 예로, 소셜 네트워크와 검색 엔진은 사용자 참여(user engagement)와 궁극적으로는 광고 클릭을 극대화하기 위해 뉴스 피드와 검색 결과를 자동으로 큐레이션한다. 이러한 알고리즘의 성공은 필터 버블과 정치적 양극화, 낚시성 콘텐츠(click bait)와 음모론의 확산, 그리고 청소년 정신건강 문제의 증가에 기여했다고 볼 수 있다. 또 다른 예는 실업자와 일자리를 연결하는 데 기계학습을 활용하는 경우다. 고용 기관들은 제안된 매칭이 실제 취업으로 이어지는 비율을 극대화하는 알고리즘의 도입을 검토하고 있다. 이런 목표가 제안된 매칭을 받아들이지 않는 구직자에 대한 불이익과 결합되면, 노동자들이 자신의 자격 수준보다 낮은 일자리에 체계적으로 배치될 수 있다. 그 결과 숙련 저하(de-skilling), 임금 하락, 노동자 후생의 감소가 나타날 수 있다.
⁵ 가치 정렬에 관한 논의는 AI 발전의 "특이점(singularity)"에 대한 예측과 결합되는 경우가 많다. 특이점이란 AI가 일단 "인간 수준의 지능"에 도달하면 스스로를 개선할 수 있게 되고, 그 결과 AI의 능력이 기하급수적으로 폭발한다는 생각이다. 여기서의 논의는 이런 가정된 특이점과 단연코 무관하다.
역강화학습
가치 정렬 문제는 알고리즘의 목적함수(보상)가 인간의 목적함수와 정확히 같지 않을 때 발생한다. 이 문제에 대한 한 가지 해법은 알고리즘이 극대화하는 보상에 인간의 목표를 더 신중하게 반영하는 것이다. 그런데 이 접근법에는 문제가 있다. 관련된 인간 목표의 복잡성을 모든 가능한 상황에 걸쳐 미리 예측하고 하나의 수치 지표에 온전히 담아내기란 매우 어렵다는 점이다.
이런 "하드코딩" 방식의 대안으로 제안된 것이 역강화학습(inverse reinforcement learning)이다(Ng and Russell (2000) 참조). 역강화학습의 발상은 인간의 행동을 관찰한 뒤, 관찰된 행동을 최적으로 만드는 보상함수를 추론하는 것이다. 이는 보상이 관찰되고 최적 행동을 학습해야 하는 강화학습의 문제를 뒤집은 것이다. 역강화학습 접근법은 관찰된 행동으로부터 선호를 추론하려는 경제학의 오랜 전통 위에 서 있다(Train (2009) 참조). 이 접근법은 때때로 "증명 가능하게 안전한 AI(provably safe AI)"라는 이름으로 홍보되기도 한다.
멀티태스킹, 대리 결과, 그리고 근본적 한계
경제 이론, 특히 메커니즘 디자인(mechanism design)과 계약 이론(contract theory)의 틀은 가치 정렬에 대해 다른 관점을 제시한다. 관련된 결과가 모두 측정 가능하지 않을 때, 자동화된 의사결정에는 근본적인 한계가 있다는 것이다. 이 한계는 더 나은 공학적 선택으로 극복할 수 없다.
AI 시스템의 설계자는 성과의 정량적 지표에 기반한 성과급 체계(계약)의 설계자와 비슷한 문제에 직면한다. 성과급 체계의 목표는 인간 대리인(agent)의 노력을 원하는 방향으로 이끄는 것이다. Holmstrom and Milgrom (1991)이 도입한 멀티태스킹(multitasking) 모형은 관찰 가능한 결과에 기반한 강력한 유인(high-powered incentives)이 왜 대리인의 행동을 심각하게 왜곡할 수 있는지, 그리고 왜 실제 고용 계약에서 이런 유인을 찾아보기 어려운지를 설명한다. 대리인의 노력이 여러 차원으로 이루어져 있고 그중 일부를 관찰할 수 없다면, 관찰 가능한 차원에 기반한 유인은 노력을 관찰되지 않는 차원에서 멀어지게 만든다. 학생의 시험 성적에 연동된 교사 유인책과 그로 인해 교육이 "시험을 위한 수업(teaching to the test)"으로 왜곡되는 현상은 많이 논의된 사례다. 생물통계학의 대리 결과(surrogate outcomes)에 관한 문헌(Athey et al., 2019)은 같은 문제를 또 다른 관점에서 바라본다. 이 문헌은 환자 사망률처럼 관심 있는 결과가, 예컨대 실현되기까지 너무 오래 걸린다는 이유로 관찰되지 않는 상황을 다룬다. 그리고 혈압이나 다른 생체 지표 같은 중간(대리) 결과를 바탕으로 인과 효과를 여전히 추론할 수 있는 조건을 논의한다.
이러한 틀들을 하나로 묶는 것은 관찰 가능성(observability)에 대한 강조다. (알고리즘이 선택할 수도 있는) 행동이 낳는 모든 관련 결과가 관찰 가능한 정량적 지표의 형태로 주어지는 것은 아니다. 측정할 수 없는 결과는 최적화 알고리즘에서 고려되지 않는다. 그리고 알고리즘이 측정된 목표를 잘 최적화할수록 이 문제는 더 심각해진다. 중요한 점은 역강화학습 같은 접근법이 이 관찰 가능성의 문제를 해결해 줄 수 없다는 것이다. 역강화학습은 인간 목표 중 측정 가능한 요소들의 가중치를 조정할 수는 있지만, 측정할 수 없는 요소를 학습할 수는 없다. 인간 대리인에게 강력한 금전적 유인을 부여하는 것이 대개 좋은 생각이 아닌 것처럼, 측정 가능한 목표를 극대화하는 강력한 알고리즘의 도입을 자제해야 하는 상황도 많을 수 있다.
이해관계의 충돌과 민주적 통제
지금까지 가치 정렬에 관한 논의는 알고리즘이 극대화하는 목표와 "인간"의 목표 사이의 차이에 초점을 맞췄다. 그러나 이 장 전체에서 강조했듯이, 인간들은 서로 매우 다른 목표를 가지며 그들 사이에는 이해관계가 충돌한다. 많은 경우 정렬 문제는 알고리즘과 인간 사이의 목표 차이라기보다는, 알고리즘의 목표를 정하는 사람들과 나머지 사회 사이의 목표 차이에 관한 문제다.
이 장의 출발점이 된 사례가 이를 잘 보여준다. 광고 클릭과 사용자 참여를 극대화하는 알고리즘을 사용하는 소셜 네트워크 운영 기업은 자사의 이윤 목표에 비추어 보면 최적으로 행동하고 있을 수 있다. 광고 클릭 극대화가 민주주의나 청소년 정신건강에 해를 끼친다면, 기업의 관점에서 그것은 이윤 추구 과정에서 생긴 안타까운 부수적 피해일 뿐, 알고리즘과 그것을 운영하는 기업 사이의 정렬 실패를 뜻하지 않는다. 특정 개인이나 조직이 운영하는 알고리즘과 사회 전체 사이의 정렬 문제를 해결하려면 예측 수단에 대한 민주적 통제(democratic control of the means of prediction)가 필요하다. 극대화할 목표에 대한 공적 토론과 집단적 의사결정만이, 자동화된 의사결정 시스템이 특정한 측정 가능한 목표를 추구하는 일이 사회적으로 이롭고 광범위한 피해로 이어지지 않도록 보장할 수 있다.
3.4 설명 가능성과 책임성
자동화된 의사결정은 책임성(accountability)에 관한 질문을 제기한다. 자동으로 내려진 결정에 대한 책임은 누구에게 있는가? 이런 결정에 이의를 제기할 수 있는가? 이런 결정을 설명할 수 있는가? 이런 결정으로 이어진 규칙 자체에 이의를 제기할 수 있는가? 특정 결정은 왜 내려졌는가? 혹은 거꾸로, 입력 특성 X가 달랐다면 결정은 어떻게 되었을까? 이와 관련해 Vredenburgh (2022)는 정보에 기반한 자기 옹호(informed self-advocacy)의 전제 조건으로서 설명을 요구할 권리(right to explanation)를 주장했다.
결정의 설명
여기서의 논의를 위해서는 개별 결정을 설명하는 것과 결정 규칙을 설명하는 것을 구분하는 것이 유용하다. 개별 결정의 영향을 받는 사람은 그 결정에 정당하게 이의를 제기하고 싶을 수 있다. 특히 그는 왜 그런 결정이 내려졌는지, 그리고 다른 결정을 얻으려면 무엇을 다르게 할 수 있었는지 물을 수 있다. 이는 2.1절에서 논의한 표적화된 처치 배정(targeted treatment assignment)의 맥락, 예를 들어 채용이나 대학 입학 같은 경우에 특히 두드러진다.
인과 추론(causal inference)의 틀(Pearl, 2000; Imbens and Rubin, 2015)이 알려주듯이, 결정이 "왜" 내려졌는지에 대한 질문은 결정 규칙과 그 도출 과정 전체를 손에 쥐고 있더라도 어느 정도 잘못 정의된(ill-defined) 질문이다. 톨스토이(Tolstoy, 1869)는 이 점을 우아하게 표현했다.
사과는 왜 익으면 떨어지는가? 중력 때문에 떨어지는가? 꼭지가 시들어서인가? 햇볕에 말라서인가, 너무 무거워져서인가, 아니면 나무 아래 서 있는 소년이 그것을 먹고 싶어 해서인가?
반면 "만약 ~라면(what if)" 형태의 질문은 잘 정의될 수 있다. 이런 질문은 경험적 사회과학에서 인과성에 대한 개입주의적(interventionist) 틀의 핵심을 이룬다(Imbens and Rubin, 2015). W = h(X) 형태의 표적화된 처치 배정 규칙의 맥락에서는, X가 다른 값을 가졌다면 결정 W가 어떻게 되었을지를 물을 수 있다. X가 개인의 선택에 따른 결과인 한, 이런 지식은 개인이 채용이나 대학 입학 같은 원하는 처치를 얻기 위해 자신의 행동을 조정할 수 있게 해 준다.
주목할 점은 이런 "만약 ~라면" 질문에 대한 답을, 원칙적으로는 인간 의사결정자보다 자동화된 의사결정 시스템에서 더 쉽게 얻을 수 있다는 것이다. 인간 의사결정자가 반사실적(counterfactual) 결정을 신뢰할 수 있게 드러내도록 하는 것보다, 컴퓨터가 X의 반사실적 값에 대해 함수 h(X)를 계산하게 하는 편이 더 쉽다. 기업 관리자의 채용 결정이나 입학 사정관의 대학 입학 결정을 생각해 보자. 이런 상황에서 우리는 채용 관리자나 입학 사정관이 반사실적 지원서에 대해 어떤 결정을 내렸을지 알 수 없다.
"만약 ~라면" 질문을 통해 결정 함수 h(X)를 설명하는 일을 어렵게 만드는 것은 특성 X가 고차원일 수 있고 사상(mapping) h가 복잡한 비선형일 수 있다는 점이다. 이 어려움은 심층 신경망에 기반한 알고리즘에서 특히 두드러진다. 이는 알고리즘 설명 가능성(algorithm explainability) 분야에서 논의되는 측면이다. 예컨대 한 가지 제안은 결정 함수의 국소 선형 근사(local linear approximation)를 보고하여 사람이 더 쉽게 읽을 수 있도록 하는 것이다.
결정 규칙의 설명
결정 규칙이 적용된 개별 사례를 넘어, 우리는 결정 규칙 자체에 대한 공적 토론과 민주적 책임성을 원할 수 있다. 설명 가능성(explainability)의 이 측면은 이 장의 나머지 논의와 밀접하게 연결된다. 규칙에 대한 설명은 규칙에 대한 민주적 통제의 필수 전제 조건이다. AI가 사회적으로 이로운 방식으로 개발되고 도입되도록 하려면, 개발과 도입에 관한 결정을 기업 엔지니어 같은 소수의 전문가와 테크노크라트 집단에 맡겨 둘 수 없다. 이들 전문가의 이해관계와 관점이 더 넓은 대중, 특히 새로운 기술의 영향을 받는 취약 집단의 이해관계 및 관점과 일치하는 경우는 드물다. 그렇다면 사회 후생의 증진에 관심을 둔 전문가들의 핵심 역할은 AI를 더 넓은 대중에게 설명하는 것이다.
알고리즘 규칙을 대중에게 설명하는 것은 불가능하다고 반론하는 이들도 있을 것이다. 특히 심층 신경망의 경우처럼, 규칙이 매우 복잡한 함수로 표현되고 복잡한 알고리즘을 통해 자동화된 블랙박스 방식으로 도출될 때는 더욱 그렇다는 것이다. 그러나 이런 반론은 잘못되었다. AI와 기계학습은 중요한 측면에서 놀라울 만큼 단순하며, 충분히 공적 토론의 대상이 될 수 있다. 이 장 전체에서 강조했듯이, AI는 데이터를 바탕으로 어떤 성과 지표를 극대화하는 알고리즘을 만드는 일이다. 민주적 토론을 위한 규칙 설명에서 핵심은 목표(성과 지표)의 정의, 고려되는 행동의 공간, 그리고 경우에 따라서는 사용된 데이터다. 나아가 주어진 알고리즘이 그 성과 지표에 비추어 얼마나 잘 작동하는지도 쉽게 전달할 수 있다. 이에 비하면 최적화 알고리즘의 구체적인 구현 방식과 작동 원리는 부차적이다.
3.5 자동화와 노동시장
기술 변화 전반, 그리고 특히 AI는 노동시장의 수요를 이동시킴으로써 개인과 사회의 후생, 그리고 불평등에 영향을 미친다. 이는 기술이 사회 후생에 영향을 미치는 가장 중대한 메커니즘 중 하나다. 이 메커니즘은 노동경제학에서 많은 관심을 받아 왔다(예컨대 Acemoglu and Autor (2011) 참조).
생산함수
기술 변화가 노동 수요에 미치는 효과는 보통 (총)생산함수(aggregate production function)를 통해 모형화된다(Mas-Colell et al. (1995), 5장 참조). 여기서는 총산출 Y가 다음과 같은 형태의 관계로 결정된다고 가정한다.
Y = y(N1, …, NJ, K1, …, KM, A). (10)
여기서 Nj는 생산에 고용된 유형 j 노동자의 수이고, Km은 사용된 유형 m 자본재의 양이다. 인자 A는 생산함수가 기술에 의존한다는 것을 나타낸다. 기술이 발전하면 A가 변하고, 함수 y는 이동하는데 대개 위쪽으로 이동한다. 총생산을 이렇게 표현할 수 있고 임금이 경쟁적인 노동시장에서 결정된다면,⁶ 각 유형 노동자의 임금은 그들의 한계생산성(이윤에 대한 기여분)과 같다. 즉,
wj = ∂y/∂Nj.
이 생산함수 틀에서 기술 변화가 임금에 미치는 효과는 이론적으로 불분명하다. A의 이동으로 수준 y가 증가할 때, 기울기 ∂y/∂Nj는 올라갈 수도 있고 내려갈 수도 있다.
기술 변화가 노동시장에 미칠 수 있는 효과 중 하나는 이른바 "숙련 편향적 기술 변화(skill-biased technical change)"다(Goldin and Katz, 2009). 숙련 편향적 기술 변화에 관한 실증 문헌은 특히 미국 노동시장에 초점을 맞춰 왔다. 이 문헌은 기술 진보로 인해 교육 수준이 낮은 노동자에 대한 수요에 비해 교육 수준이 높은 노동자에 대한 수요를 지속적으로 증가시키는 장기적 추세가 있다고 주장했다. 이러한 상대적 수요의 이동에 상응하는 상대적 공급의 이동은 일어나지 않았다. 미국에서 고학력 노동자 비중의 증가는 1980년대 이후 정체되었다. 이 주장에 따르면, 상대적 수요의 이동과 대체로 일정한 상대적 공급이 맞물려 교육 집단 간 임금 불평등이 커졌다.
그러나 21세기에 들어서면서 이런 패턴은 더 이상 들어맞지 않는 것으로 보인다. 이에 따라 문헌의 강조점도 (미국) 노동시장의 이른바 "양극화(polarization)"로 옮겨 갔다(Autor and Dorn (2013) 참조). 양극화 논의에 따르면, AI 기반 기술을 포함한 기술 진보와 자동화는 소득 분포의 중간에 있는 노동자들이 수행하던 업무에 대한 수요를 잠식했다. 전형적인 예로는 PC와 인터넷의 등장으로 영향을 받은 사무직, 그리고 로봇 사용의 증가로 영향을 받은 산업 현장의 생산직(blue collar) 일자리가 있다. 반면 소득 분포 양 끝의 업무는 자동화하기가 더 어렵다. 이런 양극화가 실제로 일어난다면, 그 결과는 중산층의 잠식이다.
⁶ 그렇지 않을 수 있는 이유는 많다. 수요독점(monopsony), 효율임금(efficiency wages), 탐색 마찰(search frictions) 등이 그 예다.
목표, 그리고 예측 수단에 대한 통제
생산함수 틀에서 곧바로 얻을 수 있는 통찰은, 기술 변화가 경제적 불평등에 미치는 효과가 미리 정해져 있지 않다는 점이다. 생산성을 높이는 기술 A의 서로 다른 변화는 특히 임금 분포에 매우 다른 영향을 미칠 수 있다. 이는 기술 변화를 권력을 가진 이들이 내리는 사회적 선택과 연결 짓는 설명, 즉 그들이 직면한 제도적·이데올로기적 제약 아래에서 이루어지는 선택과 연결 짓는 설명의 여지를 열어 준다. 이런 논의의 한 예가 Acemoglu and Johnson (2023)의 7장에 나온다. 노조의 힘과 산업별 교섭(sectoral bargaining) 때문에 기업이 일방적으로 임금을 삭감하거나 노동자를 해고할 수 없는 상황을 생각해 보자. 그 결과 이윤을 늘리기 위해 일자리를 자동화하는 데서 얻을 수 있는 잠재적 수익은 제한된다. 그렇다면 기업은 자동화를 추구하기보다, 노동자의 한계생산성을 높이는 기술에 투자하고 노동자에게 그에 맞는 훈련을 제공함으로써 이윤을 극대화하게 된다.
생산함수 틀은 AI가 경제적 불평등에 미치는 영향에 관한 논의를 구조화하는 데 매우 유용하다. 그러나 몇 가지 한계도 있다. 첫째, 생산함수 틀은 매우 유연하다. 그래서 사후적으로는 불평등의 다양한 전개를 기술 변화로 설명할 수 있지만, 검증 가능한 명확한 예측을 내놓지는 못한다. 둘째, 이 틀은 어떤 기술에나 적용된다. 생산함수에 미치는 영향이라는 측면에서 AI가 다른 기술과 구별되는 점은 아무것도 없다. 셋째, 선택이 생산함수에 영향을 미치는 기술적 경로가 이 틀에서는 열린 채로 남아 있다.
이 장에서 강조한 틀들은 AI와 관련하여 생산함수 틀에 추가적이고 보완적인 구조를 제공할 수 있다. 인공지능은 어떤 측정 가능한 목표를 극대화하는 자동화된 의사결정 시스템을 만드는 일이다. 이 목표의 선택은 예측 수단, 특히 데이터와 연산 인프라를 통제하는 이들이 한다. 그렇다면 기계학습에 기반한 기술의 도입을 어떻게 노동자, 특히 임금 분포 하위에 있는 노동자의 한계생산성을 높이는 방향으로 이끌 수 있을까? 이번에도 답은 민주적 통제다. 노동자들은 (i) 자신의 회사 안에서 어떤 종류의 데이터가 수집되는지, 그리고 (ii) 자동화된 의사결정이 어떤 목표를 극대화해야 하는지에 대해 발언권을 가져야 한다. 이러한 결정이 현재 해당 회사에서 일하지 않는 노동자들에게도 중대한 영향을 미치는 한, 이런 결정은 개별 사업장보다는 산업 수준의 민주적 거버넌스를 통해 내리는 것이 더 바람직하다. 작업장의 AI 규제는 이런 민주적 의사결정이 가능한 조건을 만들어, AI가 불평등의 추가적인 폭발과 작업장의 비인간화에 기여하지 않도록 해야 한다.
참고문헌
- Abebe, R. and Kasy, M. (2021). The means of prediction. Boston Review.
- Acemoglu, D. and Autor, D. (2011). Skills, tasks and technologies: Implications for employment and earnings. Handbook of labor economics, 4:1043–1171.
- Acemoglu, D. and Johnson, S. (2023). Power and Progress: Our Thousand-Year Struggle Over Technology and Prosperity. PublicAffairs.
- Acemoglu, D., Makhdoumi, A., Malekian, A., and Ozdaglar, A. (2022). Too much data: Prices and inefficiencies in data markets. American Economic Journal: Microeconomics, forthcoming.
- Athey, S., Chetty, R., Imbens, G. W., and Kang, H. (2019). The surrogate index: Combining short-term proxies to estimate long-term treatment effects more rapidly and precisely.
- Athey, S. and Wager, S. (2021). Policy learning with observational data. Econometrica, 89(1):133–161.
- Autor, D. H. and Dorn, D. (2013). The growth of low-skill service jobs and the polarization of the us labor market. American Economic Review, 103(5):1553–97.
- Becker, G. S. (1957). The economics of discrimination.
- Bostrom, N. (2003). Ethical issues in advanced artificial intelligence. Science fiction and philosophy: from time travel to superintelligence, pages 277–284.
- Bubeck, S. and Cesa-Bianchi, N. (2012). Regret Analysis of Stochastic and Nonstochastic Multiarmed Bandit Problems. Foundations and Trends® in Machine Learning, 5(1):1–122.
- Crenshaw, K. (1990). Mapping the margins: Intersectionality, identity politics, and violence against women of color. Stanford Law Review, 43:1241.
- Dwork, C. and Roth, A. (2014). The algorithmic foundations of differential privacy. Foundations and Trends® in Theoretical Computer Science, 9(3–4):211–407.
- François-Lavet, V., Henderson, P., Islam, R., Bellemare, M. G., and Pineau, J. (2018). An introduction to deep reinforcement learning. Foundations and Trends® in Machine Learning, 11(3-4):219–354.
- Goldin, C. D. and Katz, L. F. (2009). The race between education and technology. Harvard University Press.
- Goodfellow, I., Bengio, Y., and Courville, A. (2016). Deep learning. MIT Press.
- Gramsci, A. (1947). Prison notebooks. Columbia University Press [2010].
- Hirschman, A. O. (1986). Exit and voice: an expanding sphere of influence. Rival views of market society and other recent essays, pages 77–104.
- Holmstrom, B. and Milgrom, P. (1991). Multitask principal–agent analyses: Incentive contracts, asset ownership, and job design. The Journal of Law, Economics, and Organization, 7(special issue):24–52.
- Imbens, G. W. and Rubin, D. B. (2015). Causal inference in statistics, social, and biomedical sciences. Cambridge University Press.
- Kasy, M. (2016). Empirical research on economic inequality.
- Kasy, M. and Abebe, R. (2021). Fairness, equality, and power in algorithmic decision making. ACM Conference on Fairness, Accountability, and Transparency.
- Kitagawa, T. and Tetenov, A. (2018). Who should be treated? empirical welfare maximization methods for treatment choice. Econometrica, 86(2):591–616.
- Knowles, J., Persico, N., and Todd, P. (2001). Racial bias in motor vehicle searches: Theory and evidence. Journal of Political Economy, 109(1):203–229.
- Liscow, Z. (2018). Is efficiency biased? The University of Chicago Law Review, 85(7):1649–1718.
- Mas-Colell, A., Whinston, M. D., and Green, J. R. (1995). Microeconomic theory. Oxford University Press.
- Ng, A. Y. and Russell, S. (2000). Algorithms for inverse reinforcement learning. In ICML, volume 1, page 2.
- Pearl, J. (2000). Causality: Models, Reasoning, and Inference. Cambridge University Press.
- Pessach, D. and Shmueli, E. (2020). Algorithmic fairness. arXiv preprint arXiv:2001.09784.
- Rawls, J. (1973). A theory of justice. Harvard University Press, Cambridge.
- Roemer, J. E. (1998). Theories of distributive justice. Harvard University Press, Cambridge.
- Russell, S. (2019). Human compatible: Artificial intelligence and the problem of control. Penguin.
- Russell, S. J. and Norvig, P. (2016). Artificial intelligence: a modern approach. Pearson Education Limited.
- Saez, E. and Stantcheva, S. (2016). Generalized social welfare weights for optimal tax theory. American Economic Review, 106(1):24–45.
- Sandel, M. J. (2022). Democracy’s Discontent: A New Edition for Our Perilous Times. Harvard University Press.
- Sen, A. (1995). Inequality reexamined. Oxford University Press, Oxford.
- Shalev-Shwartz, S. and Ben-David, S. (2014). Understanding machine learning: From theory to algorithms. Cambridge University Press.
- Sutton, R. S. and Barto, A. G. (2018). Reinforcement learning: An introduction. MIT press.
- Tolstoy, L. (1869). War and peace.
- Train, K. E. (2009). Discrete choice methods with simulation. Cambridge University Press.
- Viljoen, S. (2021). A relational theory of data governance. Yale Law Journal, 131:573.
- Vredenburgh, K. (2022). The right to explanation. Journal of Political Philosophy, 30(2):209– 229.
- Wright, E. O. (2019). How to be an anticapitalist in the twenty-first century. Verso Books.
'번역' 카테고리의 다른 글
| [2024] 육후이 『기계와 주권』 서론: 행성적 사유를 위하여 번역 (2026.11.14) (0) | 2026.11.14 |
|---|---|
| [2024] 비탈릭 부테린 「크립토 + AI 응용의 가능성과 과제」 번역 (2026.11.14) (0) | 2026.11.14 |
| [2024] Plurality 한국어 번역 (7/7) 7부 앞으로, 책 소개 (2026.11.14) (0) | 2026.11.14 |
| [2024] Plurality 한국어 번역 (6/7) 6부 영향 (2026.11.14) (0) | 2026.11.14 |
| [2024] Plurality 한국어 번역 (5/7) 5부 민주주의 (2026.11.14) (0) | 2026.11.14 |